进入GPU芯片时代:专访AMD的Sam Naffziger


本文属于老雅痞原创文章,转载规矩不变,给我们打声招呼~
转载请微信联系:huangdiezi,更多DAO、Web3、NFT、元宇宙资讯请关注FastDaily,网站https://allrecode.com/ 点击阅读原文进网站查看更多资讯。
我们最近有机会与AMD高级副总裁、企业研究员和产品技术架构师Sam Naffziger交谈,了解过去几年中Radeon图形发生了什么,以及我们可以期待的未来发展。AMD最近提供了一些关于其即将推出的RDNA 3 GPU架构的细节,该架构预计将在年底前推出,采用基于芯片的设计,我们把我们的讨论提炼成了关键点。
Naffziger 在AMD工作了16年,负责多个产品领域,重点是推动每瓦特更高的性能,提高AMD的CPU和GPU的整体竞争力。他也是AMD芯片架构的主要负责人之一,该架构在Ryzen和EPYC CPU产品线中已被证明非常成功,现在将以某种形式出现在AMD RDNA 3显卡中。Naffziger概述了该公司面临的挑战,以及他认为创新技术,如基于芯片的GPU架构,可以提高性能和电源效率。
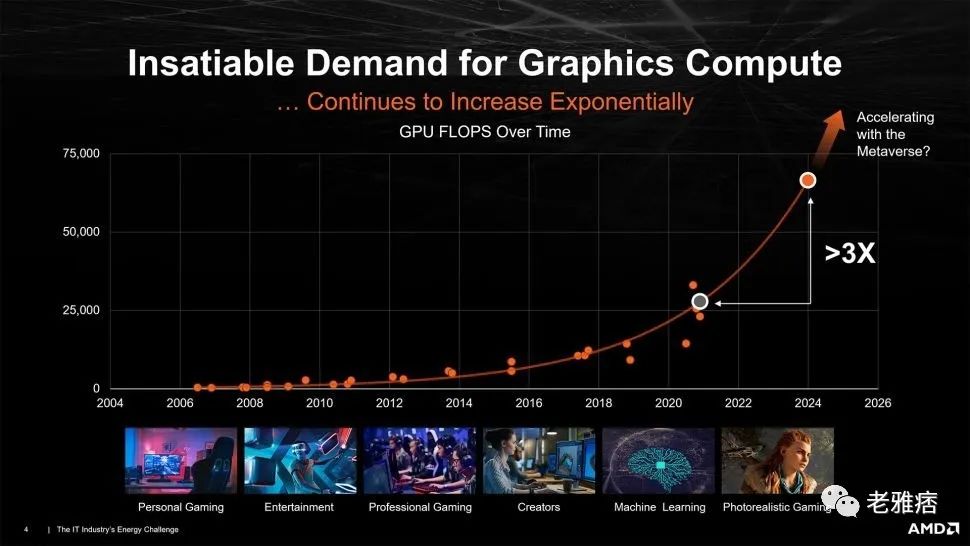
作为现代微处理器设计的核心,电源的使用和效率正变得越来越成问题,没有一家公司能免受其副作用的影响。所有迹象都表明,下一代GPU的功耗会增加。PCIe 5.0电源接口和即将推出的支持它的电源可以通过单个16针连接器提供高达600W的功率,预示着行业将更广泛地转向更高功率的GPU。基本上已知的是,Nvidia的Ada架构将推到比我们过去看到的更高的功率极限--目前的传言表明,我们可能会看到450W TBP(典型的电路板功率),甚至可能高达600W TBP,用于顶级RTX 40系列GPU。目前还没有关于AMD的RDNA 3的TBP的消息,但可以认为他们可能遵循同样的趋势。
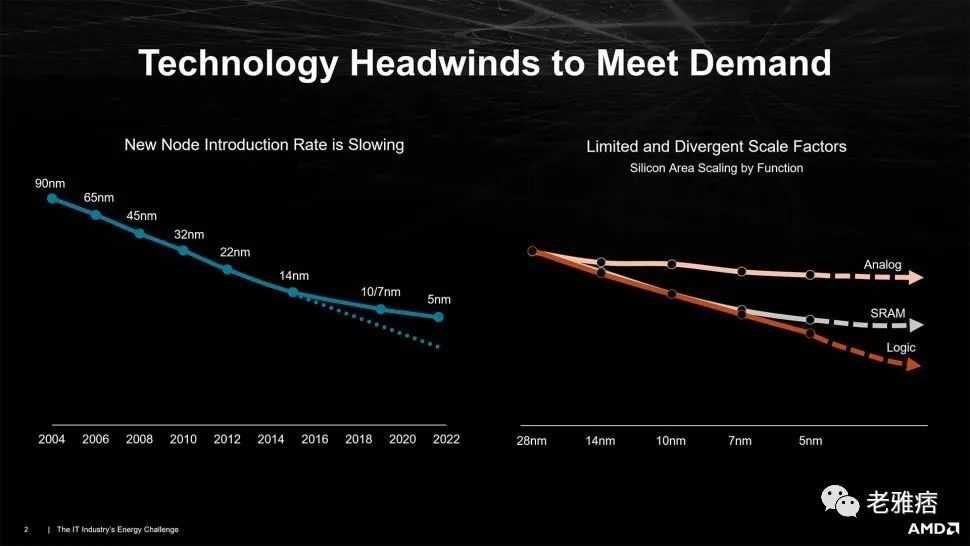
因此,尽管我们的谈话集中在AMD提高效率的方法上,但整体功耗的问题仍然存在。Naffziger证实,我们可以预期下一代GPU的总功耗会增加,但解释了专注于效率可以使性能最大化。Naffziger解释说:"这实际上是物理学的基本原理在驱动着它。对游戏和计算性能的需求,如果有的话,只是在加速,同时,底层的工艺技术正在急剧放缓--改进的速度也是如此。因此,功率水平将不断上升。现在,我们有一个多年的路线图,即非常显著的效率改进来抵消这一曲线,但趋势是存在的。"
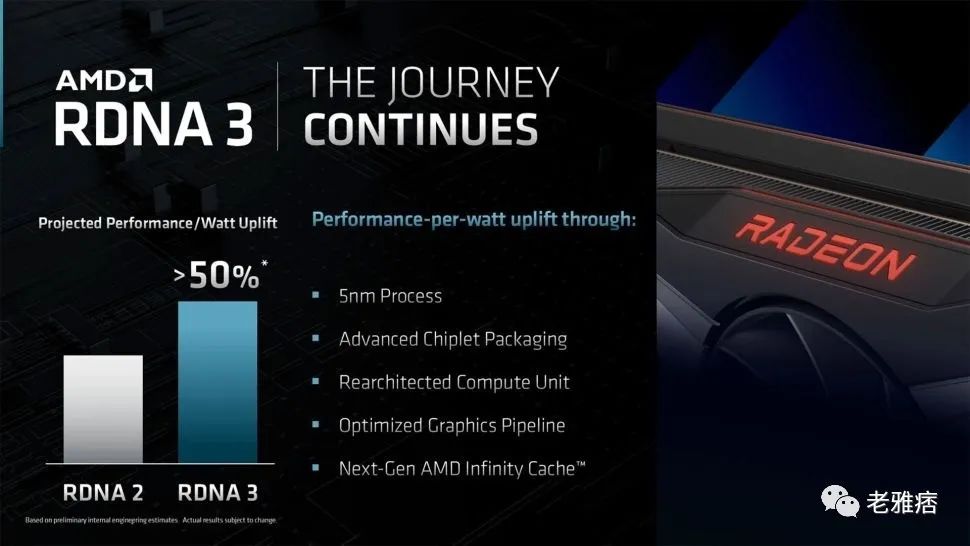
AMD声称RDNA和RDNA 2的每瓦性能提高了50%,它的目标是在RDNA 3的每瓦性能上再提高50%。这可能意味着很多不同的事情。在相同的功率下提高50%的性能,相同的性能同时减少33%的功率,或者在性能和功率曲线上的其他地方。Naffziger解释了AMD在其之前的RDNA 2架构上的一些改进。例如,如果它能在2.5GHz和1.0V而不是1.2V下运行,后者需要多40%的功率。Naffziger说,通过利用其CPU设计团队的专业知识,AMD已经能够用RDNA 3驱动更高的时钟,同时保持高效。长期以来,AMD一直在讨论其CPU和GPU设计团队的 "交叉授粉 "策略,将双方最好的技术引入每一个新的CPU和GPU设计。Naffziger说,目前的GPU核心本质上更省电。
Naffziger说:"性能是王道,但即使我们的设计更省电,这并不意味着你不把功率水平提高,如果竞争对手也在做同样的事情。只是他们必须比我们推得高得多。"换句话说,如果AMD与Nvidia类似,最终提高其顶级RDNA 3显卡的TBPs,请不要感到惊讶。
功率效率和每瓦特性能
摩尔定律带来的改进速度的挑战必须通过巧妙的工程设计和对电源效率的关注来抵消,而AMD已经在这个领域证明了自己。现在,当涉及到每瓦特的效率和性能时,AMD的Zen 3 CPU通常领先于英特尔,尽管我们必须看到Zen 4和Ryzen 7000的变化。此外,AMD的RDNA 2 GPU也倾向于在效率方面击败竞争对手Nvidia的GPU,这取决于你比较的具体型号。这一点至关重要,因为我们看到近年来快速升级到更高功率的CPU和GPU,导致更多的热量和昂贵的冷却解决方案。
具体来看AMD过去两代的图形部件,RDNA早在2019年就实现了每瓦性能比上一代Vega和Polaris架构明显提高50%或以上。例如,我们自己的GPU基准层次的测试结果显示,RX 5700 XT在我们的1080p测试套件中平均74帧,同时消耗214W,而RX Vega 64的57帧则消耗298W--这实际上是这两个部件每瓦性能的80%提升。
2020年的RDNA 2与RDNA相比,每瓦特的性能又能提高50%。例如,RX 6600在1080p ultra下的平均帧数为67,消耗137W,比RX 5700 XT的效率高41%。同时,RX 6700 XT在使用215W的情况下实现了96帧,纯效率只提高了30%,而RX 6800 XT达到124帧,使用303W,效率只提高18%。然而,RX 5500 XT 8GB的平均帧数为40帧,功耗为126W,因此RX 6600至少在某些情况下效率提高了54%--这还是使用类似的128位内存接口。
AMD在其财务分析师日上宣布,它再次致力于通过RDNA 3将每瓦特的性能提高50%,利用一系列新的能力。我们知道小芯片,特别是,将是其中的一个重要部分。Naffziger还暗示了对Infinity Cache设计的进一步优化,这将提高其有效带宽和命中率。不过,确切的细节仍在保密之中。在CPU方面,在Zen 2和后来的Zen 3中,AMD将内存控制器和PCIe通道放在一个称为I/O die的中央芯片上,同时还有一个用于与封装内其他芯片通信的高带宽接口,称为Infinity Fabric。到目前为止,这些其他小芯片包括CPU核心及其相关的缓存,以及小芯片的共享L3缓存。
对于消费级CPU,AMD发布了带有一个或两个CPU芯片的处理器,每个芯片最多可以启用八个CPU内核。然而,AMD并不只是创造一个单一的I/O芯片,因为它想扩展到多达八个CPU芯片。消费者I/O芯片只有两个CPU芯片的Infinity Fabric链接,而EPYC和Threadripper变体可以链接到多达8个CPU芯片,提供多达64核CPU,如Threadripper Pro 5995WX和EPYC 7763。对于图形解决方案,你可以说AMD自Fiji架构和R9 Fury X以来一直在玩弄小芯片封装技术。那是第一个使用HBM(高带宽内存)的产品,有一个硅插板帮助连接主GPU核心和HBM堆栈。
Naffziger没有透露他对下一代RDNA 3架构的看法,但我们的猜测是,AMD的GPU芯片设计最终会有点像目前的CPU设计,它将有容纳计算单元(CUs)、着色器核心和一些Infinity Cache的GPU芯片。然后,至少会有两种I/O芯片设计,一种可以通过更宽的内存接口扩展到更多的芯片数量,另一种可能只支持最多两个GPU芯片,AMD将通过更新的Infinity Fabric连接这些芯片,它可能会在I/O芯片上设置适度的缓存,以帮助优化内存访问。
对于GPU,如果AMD抽出所有的显示接口功能、视频编解码器、内存接口和其他通用硬件,只专注于计算单元,那么不难想象AMD创造出一个拥有40个CU芯片的构建块,它有2560(可能是5120)个着色器核心和32-64MB的L3缓存,再加上Infinity Fabric接口。基本上,采取Navi 22(RX 6700 XT),这是一个335毫米的方形芯片,并拉出大约一半的大小,并把它放到I/O芯片中。然后通过台积电的5纳米N5P节点缩小剩余的CU,AMD可以拥有一个小于100毫米见方的小芯片。同样,产量会很高,对于消费领域,AMD可能有多达四个这样的芯片组的解决方案。
I/O芯片将是一个完全不同的野兽。它将容纳外部内存接口,因此,它实际上可以通过不在前沿节点上而受益,这意味着AMD可以在N7或N6而不是N5上制造它。I/O接口往往不能很好地扩展到更小的节点上,而且外部接口通常需要更高的电压,这可能给较新的节点带来设计挑战。在一个稍旧的工艺上制造的I/O芯片上,AMD不必处理那么多问题--而且它已经拥有来自各种RDNA 2设计的现有GDDR6接口,并在台积电的7纳米工艺上进行测试和工作。
I/O芯片的主要症结将是扩展到各种目标市场。服务器的最大配置为8个芯片,这似乎是合理的,但AMD已将其消费者和数据中心的设计分别分为RDNA和CDNA。我们已经知道CDNA 3和即将推出的Instinct MI300 APU中的一些内容,它也将与Zen 4 CPU一起用于El Capitan超级计算机。RDNA 3将有很大不同,就像RDNA 2和CDNA 2一样。简而言之,我们预计AMD将不会为CDNA 3使用与RDNA 3计划相同的芯片,因此扩大到8个GPU芯片可能是不必要的。
相反,AMD可以创建两个I/O芯片组,一个用于预算和中端领域,第二个将涵盖高端和极端性能的显卡。同时,所有的GPU芯片将采用相同的核心设计。这仍然是目前RDNA 2阵容的简化,AMD已经有四个独立的芯片(Navi 21、22、23和24),更不用说像Rembrandt和Van Gogh(Steam Deck处理器)的所有集成RDNA 2解决方案。AMD可以在较小的I/O芯片上放一个128位内存接口,为低端产品提供defeatured 64位或96位变体,并能连接到两个GPU计算芯片。更大的高端解决方案可以有一个256位的内存接口(甚至可能达到384位),为较低的产品层次提供削减的选择,并能够与四个甚至更多的GPU芯片连接起来。
这听起来可能更复杂而不是更不复杂,但会有一些巨大的优势。首先,I/O芯片可以落后于前沿的一个节点,这将减少成本,而且AMD已经非常熟悉设计N7和N6产品。较小的I/O芯片最终的芯片尺寸可能在150毫米左右,仍然比Navi 23小,然后它可以根据需要与一个或两个GPU芯片相连接。更大的I/O芯片可能约为225毫米见方,可以使用三个或四个相同的GPU芯片。
在这两种情况下,总的组合芯片面积不会比单片设计差多少,但产量会好得多。AMD将把其5纳米生产集中在单一的设计上,即GPU芯片,并使用价格较低的N6或N7晶圆来生产I/O芯片。然后,唯一的诀窍是使所有这些都能正常工作,并通过更多的GPU芯片来提升性能。
其他RDNA 3架构细节
除了芯片架构,我们还从与Naffziger的谈话中收集了一些关于RDNA 3的其他细节。我们问AMD是否会在架构中加入某种形式的张量核心或矩阵核心,类似于Nvidia和Intel在其GPU上的做法。他回答说,RDNA和CDNA之间的分割意味着在消费类图形产品中塞进一堆专门的矩阵内核对目标市场来说真的没有必要,另外,以前的RDNA架构中已经存在的FP16支持应该被证明足以满足推理类工作负载。
我们的另一个问题是关于Infinity Cache的大小。RDNA 2的缓存大小从Navi 21的128MB到Navi 24的16MB不等,由此带来的性能提升,即使缓存大小较小,仍然令人印象深刻。有了标准的GPU芯片,AMD最终可能会放弃16MB的缓存而使用32MB的增量,或者可能会使用更大的缓存尺寸--或者在I/O芯片和GPU芯片中都有缓存。不管采用什么方法,Naffziger暗示了AMD在设计决策中已经学会了优化缓存使用的更好方法,包括排除某些不倾向于从缓存中受益的东西(Naffziger提到显示界面、多媒体处理和音频处理是可能不需要存储在无限缓存中的工作负载--其中一些可能从二级缓存中获得它们需要的所有缓存)。
最终,在RDNA 3这样的架构中,有很多因素需要平衡。转向小芯片有规模经济的优势,允许AMD比其他方式更快地移动到更密集的节点,但也有缺点,即移动的数据需要更高的功率。在Infinity Fabric上移动数据并不是免费的,而且,在所有其他因素相同的情况下,基于芯片的架构在数据遍历过程中会比单片设计损失一些效率。因此,必须注意确保平衡的设计。AMD一直处于芯片设计的前沿,过去三年Ryzen CPU使用了芯片,EPYC和Threadripper自2017年起使用芯片。每一代产品都带来了性能和效率的提高,我们完全期待AMD在转向基于芯片的GPU架构时,能利用其所有的经验。
我们也要清楚,虽然我们对AMD在RDNA 3上可能做的事情做了一些有根据的猜测,但Naffziger对分享具体细节肯定有点谨慎。我们曾经问过,这些芯片是否类似于Aldebaran(两个大芯片,有一个快速接口连接它们),或者更像Ryzen CPU,有一个I/O芯片和多个计算芯片。我们能从他那里得到的最好的说法是,后一种方法是 "合理的推断",而且AMD将以 "一种非常具体的图形方式 "来做其基于芯片的GPU架构。无论最终实施的具体细节是什么,我们都期待着今年晚些时候看到RDNA 3的运行。我们还想看看AMD是否还能从最大256位内存接口中获得所需的带宽,以及下一代Infinity Cache将如何发展。
但更重要的是,我们希望看到一代性能的又一次大飞跃。AMD的做法是专注于电源效率,然后使其能够在电压/频率曲线的高端提取更多的性能,这是一个合理的设计原则。当然,每一种基本的设计理念都有自己的优势和劣势,我们知道Nvidia也没有坐以待毙--可以期待在RDNA 3和40系列对决时,对性能和效率的皇冠进行激烈的争夺。


【免责声明】市场有风险,投资需谨慎。本文不构成投资建议,用户应考虑本文中的任何意见、观点或结论是否符合其特定状况。据此投资,责任自负。
来源链接