面对 GPT-4,NLP 工程师还是有办法的!
本文 3800 字左右
- 到底是“左右逢源”还是“举步维艰”,让子弹飞一会儿吧。
- 所谓技术壁垒也许就是如何更清晰有效的描述需求了,但也很难形成技术壁垒。至于专利,软件著作权保护的是制作软件这个技术本身,而非你使用软件时的姿势,所以我想单独的 prompt 应该也不会形成专利,但是作为你某个技术的一部分,还是有可能的。
- LLM 现阶段的表现是“懂开车的人才能开车”,所以需要更多更懂某个业务,更熟练使用 LLM 工具的人。
这篇文章的目标:讨论在当前 GPT-4 如此强大的技术冲击下,普通 NLP 算法工程师该何去何从。本文章主要用来引发思考 + 讨论,如果您是 NLP 算法工程师,有什么新的观点或者 Comment,可以加微信Alphatue
首先说下结论:GPT-4 非常强大,但是我们认为,还没有到彻底取代 NLP 算法工程师工作的地步,依然有很多能做的方向。本文分为以下几部分:
一、GPT-4 厉害在哪里?
二、GPT-4 存在的问题
三、NLP 工程师可以努力的方向
四、何去何从
五、申请 Prompt 专利?我们会不会失业?
为什么?详情可见 OpenAI 的 GPT-4 Technical Report(下图) 具体意思是,和以前的 GPT-3.5 模型相比,GPT-4 大大减少了胡说八道的情况。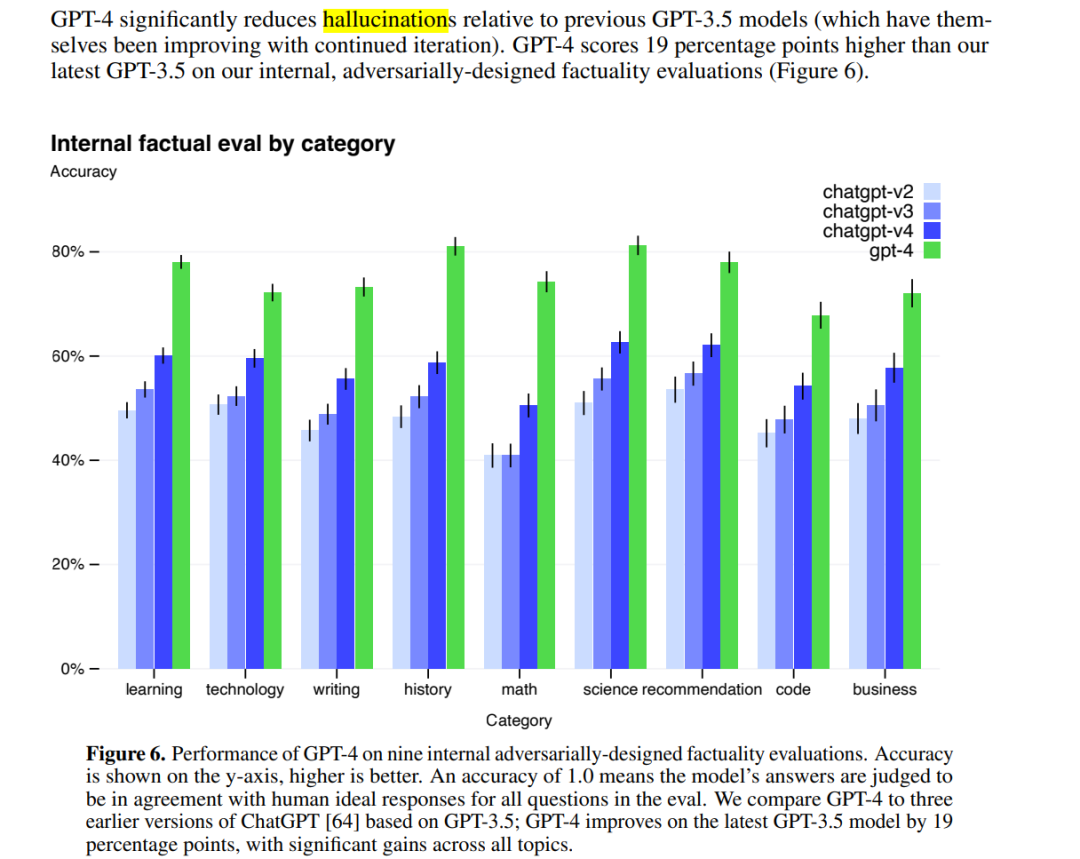
具体表现在哪?根据论文里的例子,我们发现 GPT-4 在技术上有几个进步:
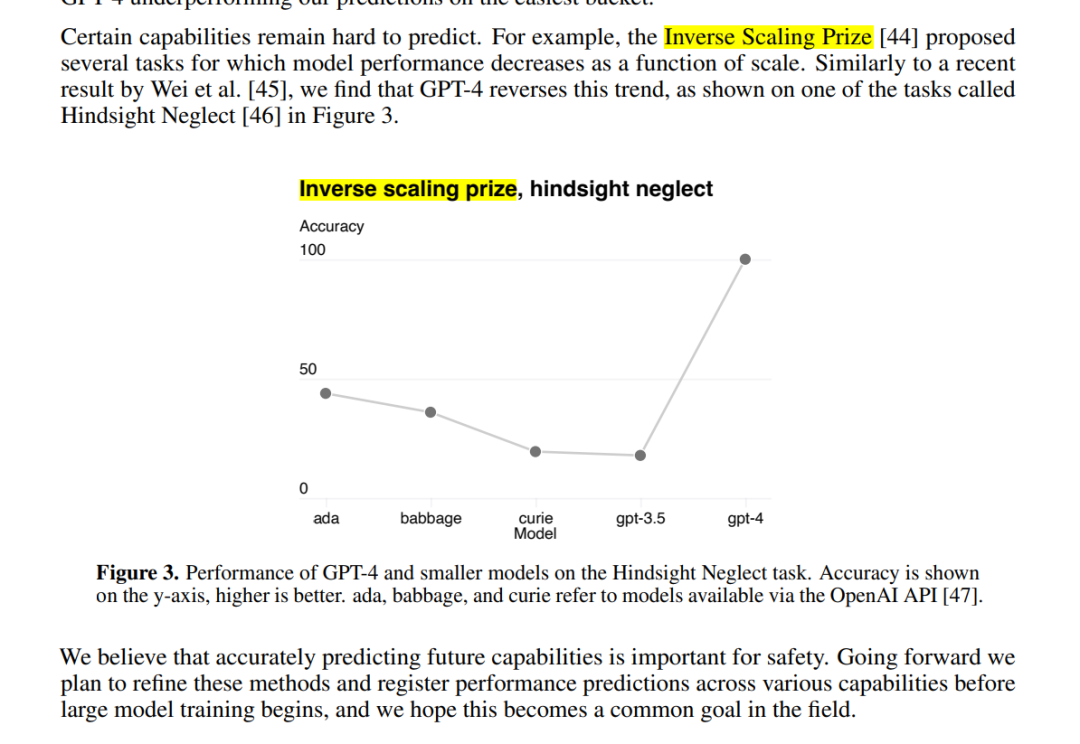
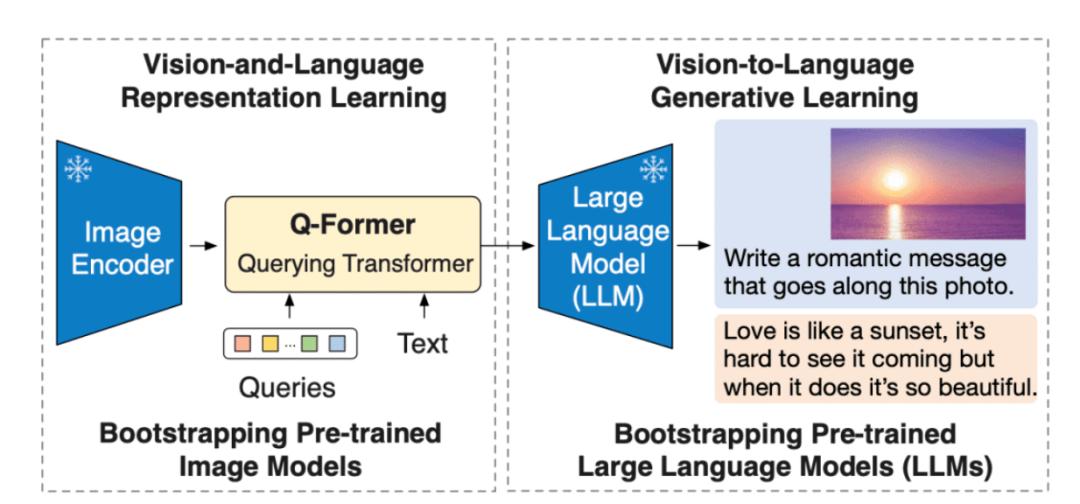
第一,多模态处理能力:GPT-4 可以接受包含文本和图片的输入,并生成包括自然语言和代码在内的文本输出。这使得它在处理文档、图表或屏幕截图等任务时表现出色。第二,更好的性能和表现:相比前代 GPT-3.5,在处理复杂任务时表现更为出色,在各大面向人类的考试中展示出了更高的准确性、可靠性、创造力和理解能力。第三,Test-Time Techniques 扩展能力:GPT-4 使用了 Test-Time Techniques 如 few-shot 和 chain-of-thought prompting 进一步扩展了其能力,使其能够更好地处理新领域和任务。第四,安全性优化:GPT-4 重视安全性,生成回复的正确性得到了重点优化。它还进行了对抗性真实性评估,以避免潜在的安全隐患。第五,开源框架支持:OpenAI 开源了用于评价大语言模型的开源框架 OpenAI Evals,可以帮助研究人员和开发者评估他们的模型,并提供更好的指导。第六,模型训练和监控:OpenAI 强调对模型进行评估和监控的重要性,以避免潜在的安全隐患。GPT-4 也已被应用在了 OpenAI 内部,例如内容生成、销售和编程,并在模型训练的第二阶段负责输出评估、对齐工作。这里我们也抛一个问题:( 究竟如何定义“模型的性能?”模型越来越难评估了,比如说,市场认为的某些某些不如 chatgpt,但是也有人测试觉得更好,是怎么定量的评估呢?)3.Reverse inverse scaling prize:一些随着模型变大性能下降的任务,在 GPT-4 上不再出现类似现象(曾经没法通过增大模型规模提升性能的任务现在也解决了)如何理解reverse inverse scaling prize?通过阅读论文原文,Inverse Scaling Prize 提出的几个任务,模型性能会随着 scale 的扩大而下降,但是我们发现 GPT-4 扭转了这一趋势。也就是说,GPT-4 scale 扩大,性能也不会下降。见下图:- 能够用图像做 prompt:增加图像信息能进一步提升性能(看图说话,类似 BLIP2,这个对视力存在问题的朋友太友好了)
论文:https://arxiv.org/pdf/2301.12597.pdfSalesforce 研究院的 BLIP-2 模型,是一种视觉语言模型,可以用于图像字幕生成、有提示图像字幕生成、视觉问答及基于聊天的提示等多种应用场景。BLIP-2 通过引入一种新的视觉语言预训练范式来解决端到端视觉语言预训练的高成本问题,并实现了在多个视觉语言任务上最先进的结果,同时减少了训练参数量和预训练成本。1.不开源
由于 GPT-4 完全不公布任何技术细节,所以为什么它有如此强大的能力,我们只能猜,想要研究它变得困难重重。2.数据安全
ChatGPT 的火爆让大家突然忘了曾经非常看重的数据安全问题,preview 版是有可能会参与下次迭代的;而商用 API 即使强调不会用于模型训练,敏感业务数据你敢用吗?3.资源消耗大
即使是 GPT-3 也有 175Billion(1750 亿) 参数,所有的训练 / 推理都是极其消耗资源的,从 GPT-4 的价格上涨了 50% 来看,我们认为 GPT-4 的推理消耗资源也上升了约 50% 左右。这也是最近讨论比较热烈的一个问题。在我们探讨这个问题之前,可以先思考一下理想的 NLP 模型应该具有哪些特征。我们认为,比较理想的模型是:
安全可靠 / 支持长文本 / 小 / 快 / 私有化部署。
所以从个人观点出发,给出一些我们比较关注的方向,抛砖引玉:1.hallucination
目前 LLM 最大的问题就是 hallucination(hallucination 举个例子,就是 ChatGPT 会一本正经的胡说八道 )。那么目前主流两种思路:alignment/ 多模态。①alignment:alignment 就是让模型理解人类语言
②多模态:多模态(Multimodality)是指涉及多个感官或媒体形式的信息处理和表达方式。在自然语言处理和计算机视觉等领域,多模态通常是指同时处理和理解多种输入方式,如文本、音频和图像等。多模态信息处理可以帮助计算机更好地理解复杂的人类交互和情境,从而提高计算机的智能化水平和应用效果。例如,在图像字幕生成任务中,计算机需要同时处理图像和文本,根据图像内容生成相关的文字描述。- Alignment 至于如何做 alignment ,学术界主要是 instruction-tuning 为主,OpenAI 的路线是 RLHF,然而普通玩家我是完全不推荐做 RL 的,只要仔细阅读 InstructGPT/GPT-4 paper 中关于 reward model 部分就能劝退了(原因:因为 Reward model 太难做啦,你要用模型来模拟人的偏好,贼难...instructgpt 里是直接过拟合训的,gpt4 是加了一堆规则)。所以对于我们普通玩家,是否有别的路径?
- 多模态 GPT4 的 Paper 上看,效果是不错的,不过我们目前还在实践,欢迎实践过的同仁来讨论。
2.复现 GPT-4/ChatGPT/GPT-3.5/InstructGPT
不开源只能复现,目前主要有[facebookresearch/llama](https://github.com/facebookresearch/llama)/[bigscience/bloom](https://huggingface.co/bigscience/bloom)此外还有不开源但是可以使用 API 访问的百度文心一言 /ChatGLM 等。3.如何评估 LLM
很多人提到百度文心一言性能“不够好”,具体指的是哪里不够好?究竟如何量化评估 LLM 的性能?曾经自动化的方案及 Benchmark 的参考意义,随着 LLM 的能力提升显得越来越弱,现在急需新的数据集 / 评估方案。[openai/evals](https://github.com/openai/evals)[stanford-crfm/HELM](https://github.com/stanford-crfm/helm)4.支持长文本
更长的输入,对某些任务是有利的,那么如何让模型支持更长的输入?
- 训练时使用较短文本,推理时外推更长的位置信息,使模型获得处理长文本的能力,如 bloom 中使用的[ALiBI](https://arxiv.org/pdf/2108.12409.pdf)
- 调整模型结构,如最近的工作:[CoLT5:Faster Long-Range Transformers with Conditional Computation](https://arxiv.org/pdf/2303.09752.pdf)
PS: GPT-4 的输入从 GPT-3.5 的 4K(or 8K?) 提升到了 30K,具体是如何做的呢?5.变小变快
相同架构的模型通常变小就会变快,让模型变小的方法主要是蒸馏 / 量化 /train 小模型,这个方向目前工作有:[stanford_alpaca](https://github.com/tatsu-lab/stanford_alpaca)[bitsandbytes](https://github.com/TimDettmers/bitsandbytes),中文上也有[ChatGLM-6B](https://github.com/THUDM/ChatGLM-6B)/[BELLE](https://github.com/LianjiaTech/BELLE) 等6.低成本 inference
如何在低成本设备上使用这些模型?如单张 GPU 上跑大模型或普通 CPU 上跑模型。这个方向的工作也有[FlexGen](https://github.com/FMInference/FlexGen)/[llama.cpp](https://github.com/ggerganov/llama.cpp) 等。7.低成本优化
- parameter-efficient 的思路目前主要有 prompt-tuning/prefix-tuning/LoRA/Adapter 等
(https://github.com/huggingface/peft)- sample-efficient 可以帮助我们如何更有效的构造训练集
最近的工作有[Simfluence: Modeling the Influence of Individual Training Examples by Simulating Training Runs](http://arxiv.org/abs/2303.08114)8.优化器
优化器决定了我们训练时需要的资源。虽然我们通常使用 Adam 优化器,但是其需要 2 倍额外显存,而 google 好像用 Adafactor 更多一点,最近他们又出了一个新工作- [Lion](https://arxiv.org/abs/2302.06675).
9.更可控
如从可控生成角度看,目前可控主要通过 control token(prompt)来实现,有没有更好的办法来实现更“精细”的控制?正如 controlnet 之于 stable diffusion。10.识别 AIGC
如何判别内容是人写的还是模型生成的呢?随着模型的性能越来越强,识别 AIGC 也越来越困难。目前的工作也有 watermark/[GPTZero](https://gptzero.me/) 等对此我有个简单的思路:将 AI 生成的与非 AI 生成的看作是两种不同的语言,如 code 与英语一样,虽然都是相同符号构成,但是对应不同语言。使用大量的 AI 生成的内容(或人机交互数据)pretrain 一个”AI 语言模型“,再来进行识别。11.单一任务 / 领域刷榜
我认为在某个任务 / 领域上通过小模型挑战大模型依然有意义,LLM 虽然强大,但是依然有太多我们不知道的能力,通过小模型刷榜也许能提供一些思路,就像 PET 本意是挑战 GPT-3,却打开了 LLM 的新思路。1.普通工程师
这种新的革命性的技术我们普通工程师通常都不是第一线的,我们第一次真正使用 bert 也是在其出来两年后了。即使今天,也有很多场景 / 公司不使用 bert 这个技术。换个角度,即使我们想参与,我想能参与训练 /fine-tuning 一个 10B 规模模型的工程师都相当少,更别提更大的了。所以到底是“左右逢源”还是“举步维艰”,让子弹飞一会儿吧。2.普通用户
对于普通用户来说,要努力提高自己的鉴别能力(究竟什么是真?什么是假?什么是好?什么是坏?)1.通过 Prompt 构建技术壁垒 / 申请 prompt 专利
随着 alignment 的进一步优化,LLM 通常越来越理解自然语言,所以我们认为 prompt-trick 越来越不重要,而清晰地用 prompt 描述你的需求越来越重要。所谓技术壁垒也许就是如何更清晰有效的描述需求了,但也很难形成技术壁垒。至于专利,软件著作权保护的是制作软件这个技术本身,而非你使用软件时的姿势,所以我想单独的 prompt 应该也不会形成专利,但是作为你某个技术的一部分,还是有可能的。2.会不会失业
我们认为不会失业,但会转变一部分人的工作方式。在计算这件事上,人类早已被计算机远远地甩在后面,而计算机的出现也带来了大量的新工作。尤其是 LLM 现阶段的表现是“懂开车的人才能开车”,所以需要更多更懂某个业务,更熟练使用 LLM 工具的人。【免责声明】市场有风险,投资需谨慎。本文不构成投资建议,用户应考虑本文中的任何意见、观点或结论是否符合其特定状况。据此投资,责任自负。
来源链接